Nota
SOAR
Utilizzando AlloyDB for PostgreSQL mi sono interessato all'algoritmo sottostante, basato su ScANN e recentemente esteso con SOAR.
In fase di indexing si costruisce una struttura per organizzare i vettori nello spazio, in modo da fare ricerca solo su sottoinsieme. I vettori vengono quantizzati e assegnati a diverse partizioni tramite SOAR. Analizziamo
Ho i dati in un database vettoriale e una query . Voglio ritornare i più vicini a . Facendo una ricerca lineare ottengo tutti dati esatti ma è inefficiente (intractable) data la maledizione della dimensionalità. Approssimo l'esattezza per guadagnare efficienza, da qui Approximate Nearest Neighbor
Spill Tree
Replicazione dei dati per ridurre errori di partizionamento.
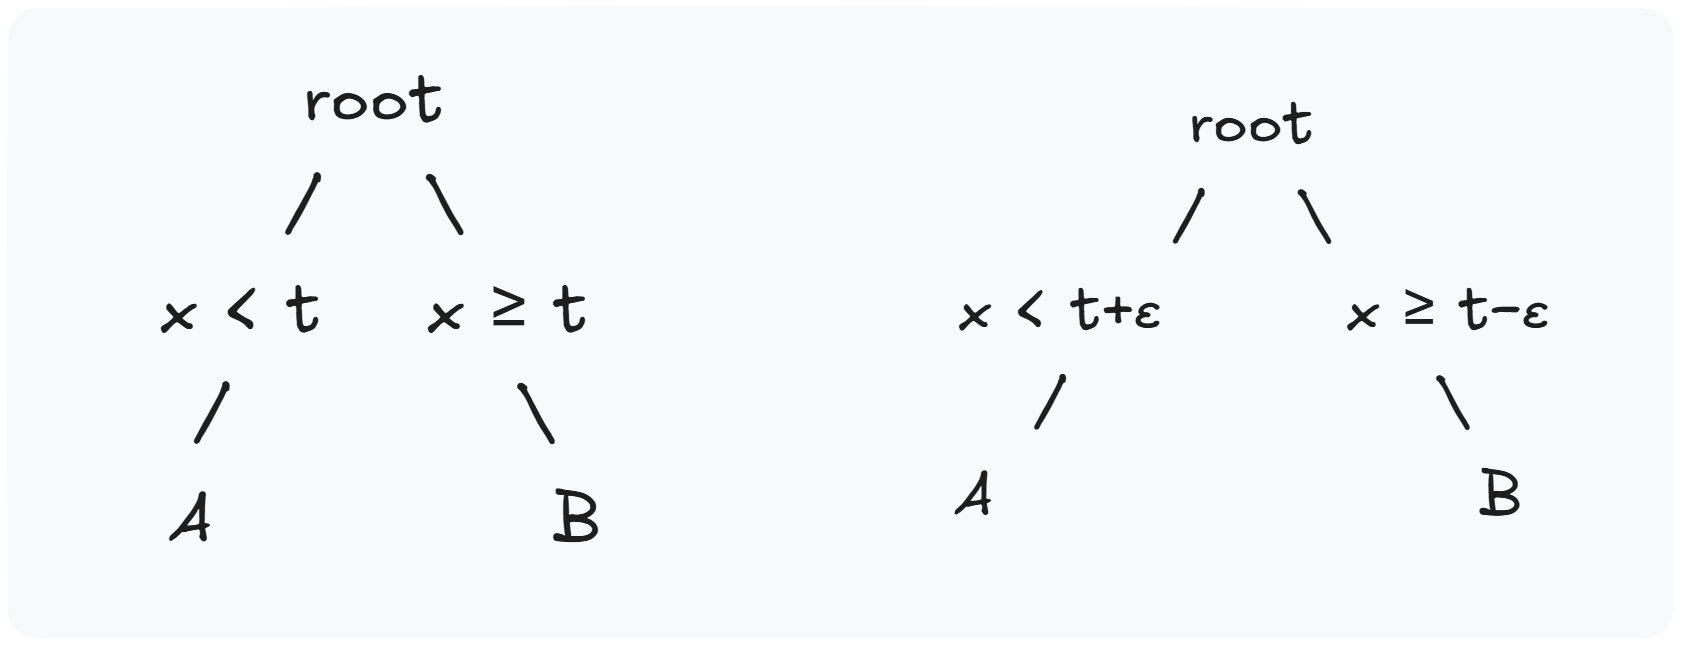
Qui vediamo come un iperpiano di separazione, divide lo spazio in due regioni. Si introduce un overlap in modo i punti vicini al confine siano replicati sia in che in
Ma la complessità è esponenziale, se a ogni livello dell'albero un punto cade nella zona di overlap viene duplicato in entrambi i figli e comparirà volte.
Vector Quantization
Approssimo i valori dei vettori con dei centroidi. Questo processo ritorna due oggetti: codebook e funzione di assegnazione
C \in \mathbb{R}^{c\times d} \tag{1}
è una matrice di righe, ognuna un vettore in , quindi ogni riga è un centroide.
\pi(v):\mathbb{R}^d \mapsto \{1,\dots, c\} \tag{2}
La funzione di assegnazione fa si che ogni vettore sia assegnato al centro più vicino. Così in fase di query calcoliamo il prodotto scalare tra e tutti i centroidi , ordiniamo per punteggio e recuperiamo i punti di quelle partizioni.
Questo non avviene gratis, perchè sostituendo con il suo centroide introduciamo dell'errore.
Residuo
Ciò che perdiamo sostituendo con il suo centroide
Più è grande e positivo più sottostima il punteggio reale e la partizione giusta può non essere visitata. Questo accade quando il residuo è allineato con la query
Spilling with Orthogonality-Amplified Residuals
Per evitare che un punto venga perso durante la ricerca lo assegniamo a più partizioni. Ma come scegliamo a quale altra partizione?
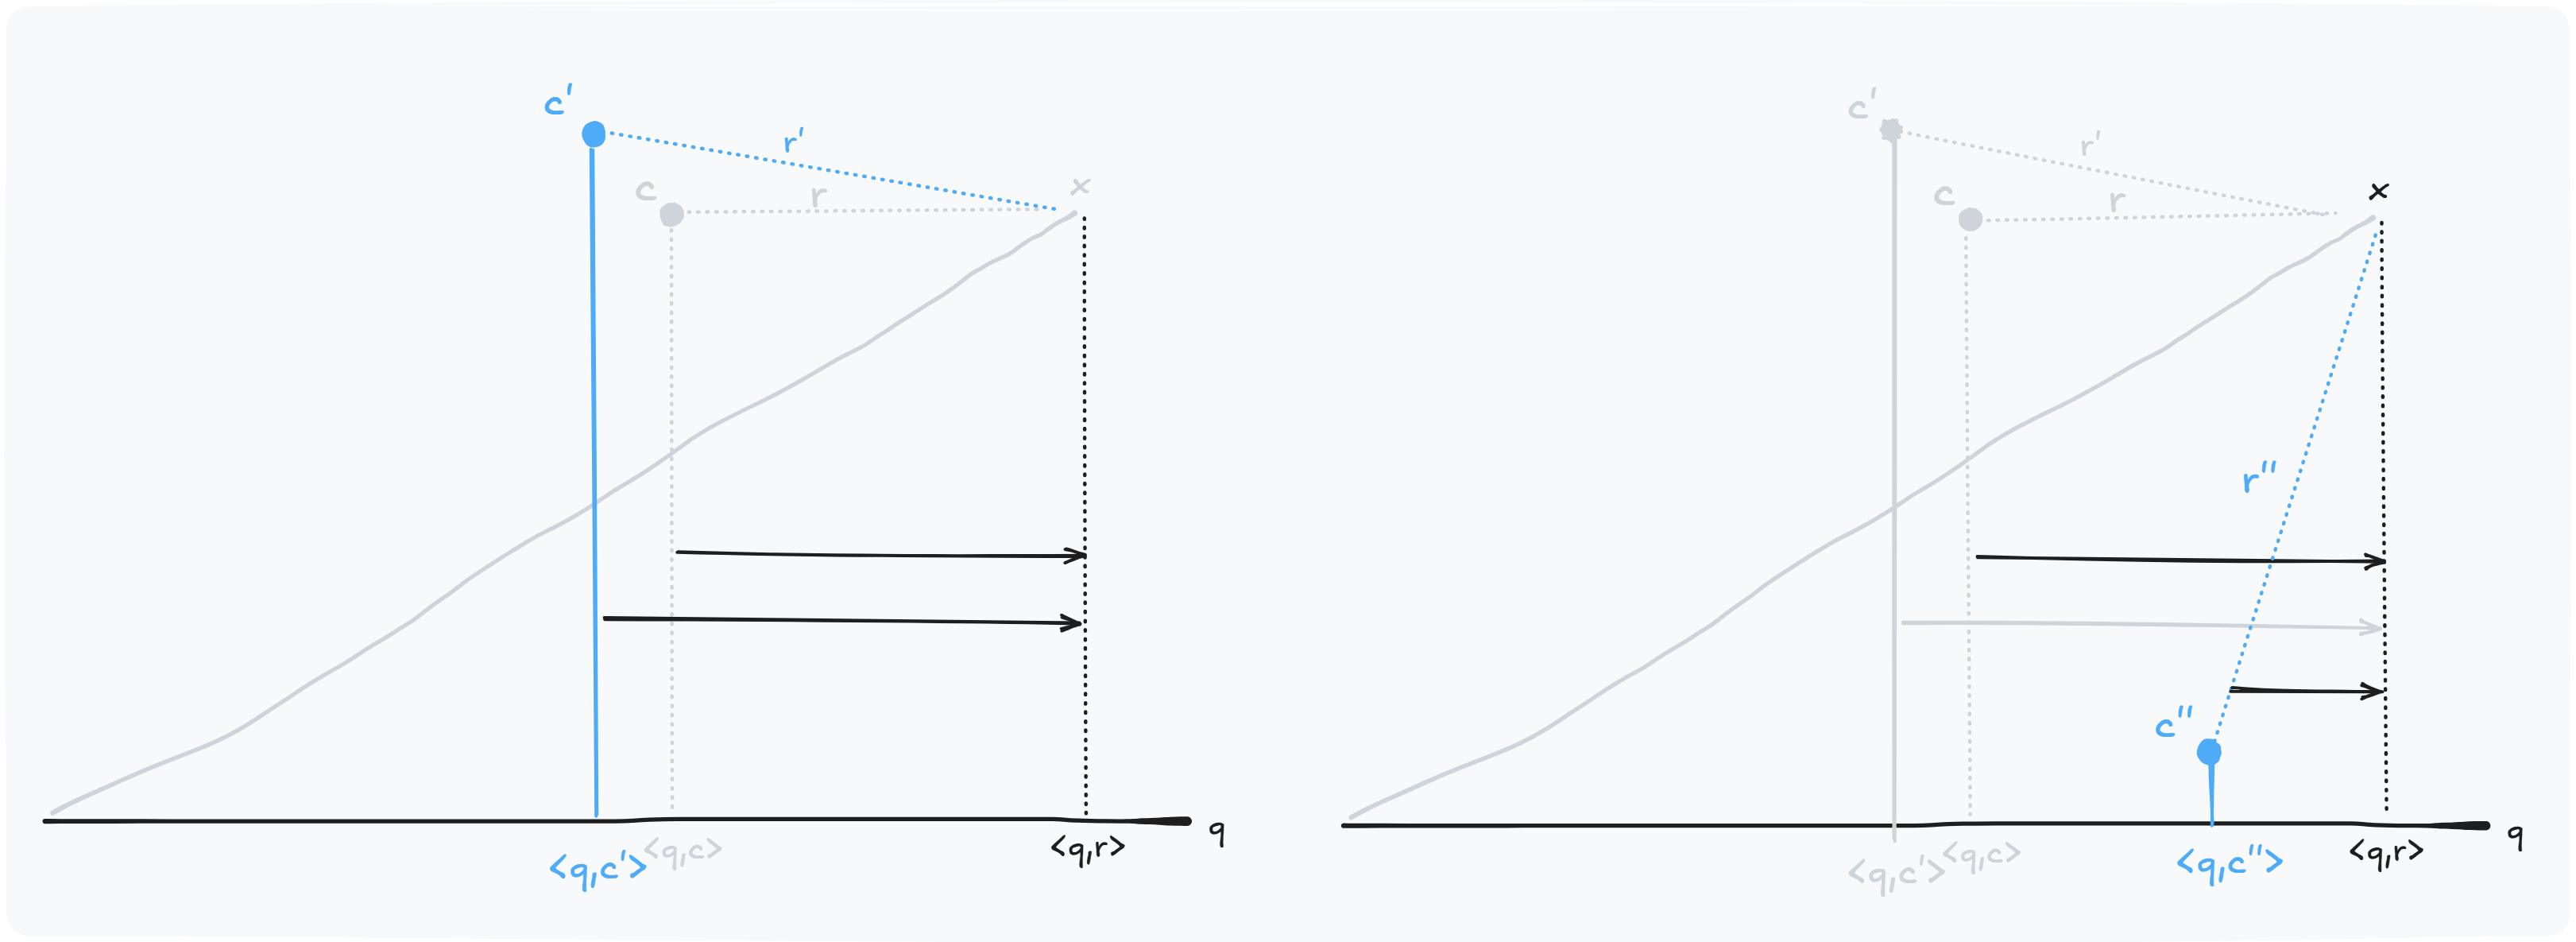
A sinistra, vediamo che scegliendo , il nuovo residuo ha una direzione simile a . A destra viene scelto tale che il residuo sia quasi ortogonale a
Così almeno una delle due approssimazioni mantiene un buon punteggio rispetto a . Per rispondere alla domanda precendete, scegliamo il centroide tramite una loss che minimizza l'errore di quantizzazione e penalizza l'allineamento tra residui.
dove:
- è il residuo della prima assegnazione
- è il residuo candidato
- è una query 1
- è l’angolo tra e
- pesa di più i casi in cui l’errore originale è alto, quindi è allineato con
Tutte queste assegnazioni multiple aumentano i costi di memoria e indicizzazione in modo lineare con il numero di copie per punto. Viene dimostrato che già una seconda assegnazione è sufficiente a coprire la maggior parte dei casi, ulteriori assegnazioni portano benefici marginali rispetto ai costi.
Link al paper ufficiale: https://arxiv.org/pdf/2404.00774
Footnotes
-
Si può considerare come campione rappresentativi dei casi reali, la distribuzione delle query che ci aspettiamo durante l’uso del sistema ↩